Jawaban singkat: data yang tidak normal bukan alasan mengulang penelitian. Periksa dulu apakah yang Anda uji memang objek yang benar, lalu pilih satu dari empat jalan keluar: perbaiki penyebabnya, transformasi variabel, pindah ke uji nonparametrik, atau gunakan bootstrap. Semua jalur itu sah dan lazim diterima penguji asalkan alasannya Anda tulis di bab tiga.
Malam sebelum bimbingan, Anda menjalankan uji normalitas dan angkanya keluar 0,003. Layar SPSS menampilkan tanda bintang, forum-forum menyarankan hal yang saling bertentangan, dan muncul rasa panik bahwa seluruh data harus dikumpulkan ulang. Tidak perlu. Halaman ini menjawab satu pertanyaan saja: apa langkah berikutnya yang benar ketika sebaran data Anda gagal uji normalitas, dan bagaimana menuliskannya supaya tidak menjadi bahan serangan di ruang sidang.
Apa arti “data tidak normal” dalam uji normalitas?
Uji normalitas menguji hipotesis nol bahwa data berasal dari populasi yang berdistribusi normal. Nilai signifikansi di bawah 0,05 berarti hipotesis nol ditolak, yaitu sebaran data Anda menyimpang dari kurva normal secara statistik. Perhatikan arah logikanya, karena inilah yang paling sering terbalik dalam skripsi: pada uji normalitas, signifikan justru berarti buruk. Anda ingin nilai Sig. lebih besar dari 0,05.
Dua uji yang ditampilkan berdampingan oleh SPSS pada menu Analyze → Descriptive Statistics → Explore adalah Kolmogorov-Smirnov dengan koreksi Lilliefors dan Shapiro-Wilk. Keduanya menjawab pertanyaan yang sama dengan kepekaan berbeda. Shapiro-Wilk umumnya lebih peka pada sampel kecil dan menjadi rujukan utama pada penelitian dengan responden puluhan; Kolmogorov-Smirnov lebih longgar. Ketika keduanya berbeda arah, laporkan keduanya dan sebutkan mana yang Anda jadikan dasar keputusan beserta alasannya. Menyembunyikan salah satunya adalah kesalahan yang mudah terlihat begitu penguji meminta tangkapan layar keluaran asli.
Data mana yang sebenarnya harus normal: data mentah atau residual?
Ini adalah pertanyaan yang membatalkan sebagian besar kepanikan. Pada analisis regresi linear, asumsi normalitas tidak berlaku untuk setiap variabel secara terpisah. Yang harus mendekati normal adalah residual, yaitu selisih antara nilai yang diamati dan nilai yang diprediksi model. Variabel pendapatan boleh menceng tajam ke kanan, variabel lama kerja boleh bertumpuk di angka kecil, dan model regresi Anda tetap memenuhi asumsi selama residualnya berperilaku baik.
Banyak mahasiswa menguji normalitas pada kolom X dan kolom Y satu per satu, mendapatkan Sig. 0,000 pada keduanya, lalu menyimpulkan bahwa regresi tidak boleh dilanjutkan. Kesimpulan itu keliru secara metodologis. Di SPSS, simpan residual tak terstandar melalui tombol Save pada dialog regresi, lalu jalankan uji normalitas pada kolom residual yang baru terbentuk. Untuk uji beda seperti uji t dan ANOVA, yang diasumsikan normal adalah sebaran data di dalam setiap kelompok, bukan sebaran gabungan seluruh responden. Menguji kolom gabungan pada data dua kelompok yang rata-ratanya berjauhan hampir selalu menghasilkan sebaran bimodal yang gagal uji, padahal masing-masing kelompok normal.
Mengapa uji normalitas sering gagal justru pada sampel besar?
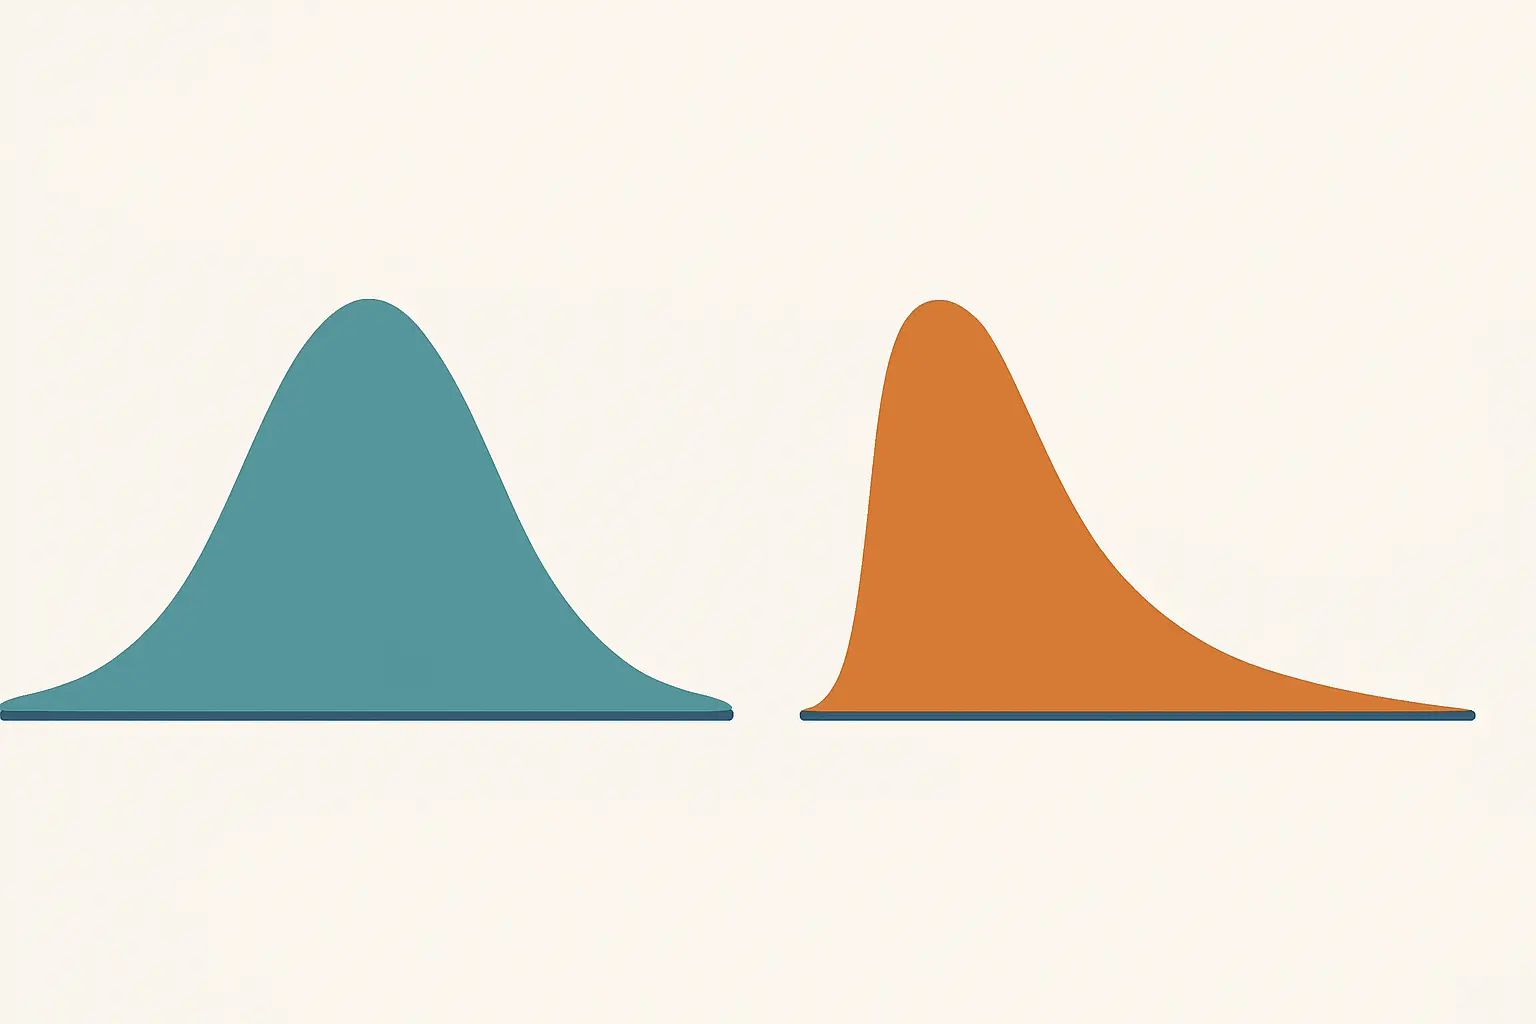
Uji normalitas adalah uji signifikansi, dan seperti semua uji signifikansi, dayanya meningkat seiring bertambahnya jumlah data. Pada 400 responden, simpangan yang sangat kecil dari kurva normal sudah cukup untuk menghasilkan Sig. 0,000, sementara pada 30 responden simpangan yang jauh lebih besar tetap lolos. Akibatnya paradoks: semakin rajin Anda mengumpulkan data, semakin besar peluang uji normalitas menyatakan data Anda tidak normal.
Karena itu keputusan tidak boleh bergantung pada satu nilai Sig. saja. Lihat juga bentuknya. Histogram dengan kurva normal, plot Q-Q, serta nilai skewness dan kurtosis memberi informasi yang tidak diberikan oleh angka signifikansi. Konvensi yang lazim diajarkan di kampus Indonesia adalah menganggap sebaran cukup simetris bila skewness dan kurtosis berada dalam rentang sekitar −2 sampai +2. Konvensi ini bukan aturan resmi mana pun, jadi tulislah sebagai konvensi dan sebutkan sumber buku metodologi yang Anda ikuti. Bila jumlah responden Anda masih dalam tahap perencanaan, pertimbangan seperti ini sebaiknya dibaca bersama cara menentukan jumlah sampel skripsi sebelum kuesioner disebar.
Kapan ketidaknormalan boleh diabaikan?
Ada situasi di mana jawaban yang benar adalah melanjutkan analisis dan menjelaskan alasannya. Uji t dan ANOVA dikenal cukup tahan terhadap penyimpangan normalitas ketika ukuran kelompok besar dan relatif seimbang, karena yang perlu mendekati normal adalah sebaran rata-rata sampel, bukan sebaran data mentah. Semakin besar sampel, semakin dekat sebaran rata-rata itu pada kurva normal.
Yang tidak boleh Anda lakukan adalah mengabaikannya tanpa berkata apa-apa. Bedanya besar. Menulis “data tidak berdistribusi normal, namun karena ukuran sampel 220 dan kelompok relatif seimbang, uji t tetap digunakan dengan merujuk sifat ketahanan uji tersebut” adalah keputusan metodologis yang dapat dipertahankan. Diam saja, lalu ditanya penguji, adalah cerita yang berbeda.
Pilihan 1: apakah penyebabnya bisa diperbaiki lebih dulu?
Sebelum mengubah data atau mengganti uji, telusuri penyebabnya. Empat penyebab berikut menyumbang sebagian besar kasus di skripsi kuantitatif Indonesia.
- Salah input. Usia tertulis 250, skala Likert 1–5 berisi angka 55, koma desimal terbaca sebagai ribuan. Urutkan setiap variabel dari terkecil dan terbesar, lalu periksa lima nilai di kedua ujungnya. Cara ini menemukan lebih banyak masalah daripada uji apa pun.
- Pencilan sejati. Satu responden dengan pendapatan sepuluh kali lipat median dapat mengubah hasil uji normalitas sendirian. Pencilan tidak otomatis boleh dibuang. Bila responden itu memang bagian dari populasi yang Anda teliti, membuangnya berarti mengubah populasi penelitian, dan itu harus dijelaskan, bukan disembunyikan.
- Populasi campuran. Data karyawan tetap dan pekerja lepas dalam satu kolom sering menghasilkan dua puncak. Jawabannya bukan transformasi, melainkan memisahkan analisis atau memasukkan status kerja sebagai variabel.
- Efek langit-langit dan lantai. Bila hampir semua responden menjawab 5 pada skala 1–5, sebaran menumpuk di batas atas dan tidak akan pernah normal. Ini adalah temuan tentang instrumen, bukan tentang data. Sebutkan di keterbatasan penelitian.
Pilihan 2: apakah transformasi data layak dicoba?
Transformasi mengubah skala variabel agar sebarannya lebih simetris. Tiga bentuk yang paling sering dipakai: logaritma natural untuk sebaran menceng ke kanan yang tajam seperti pendapatan dan omzet; akar kuadrat untuk data cacahan yang menceng ringan; dan kebalikan nilai untuk kasus ekstrem. Semua transformasi ini menuntut nilai positif, jadi bila ada nol atau nilai negatif Anda perlu menambahkan konstanta lebih dulu dan menyebutkan konstanta itu di naskah.
Harganya nyata dan sering diremehkan. Setelah transformasi, koefisien Anda tidak lagi berbicara dalam satuan asli. Koefisien pada model dengan logaritma pendapatan tidak berarti “setiap penambahan satu rupiah”, melainkan berkaitan dengan perubahan persentase. Bila Anda tidak siap menafsirkan dan mempertahankan tafsir itu di sidang, transformasi bukan pilihan yang tepat untuk Anda. Aturan praktis yang jujur: gunakan transformasi bila teori di bidang Anda memang lazim memakainya, bukan semata karena ingin nilai Sig. berubah.
Pilihan 3: kapan sebaiknya pindah ke uji nonparametrik?
Uji nonparametrik tidak mensyaratkan sebaran normal karena bekerja pada peringkat, bukan pada nilai asli. Untuk sampel kecil dengan sebaran yang jelas menyimpang, jalur ini biasanya paling aman dan paling mudah dipertahankan. Tabel berikut memetakan padanannya.
| Uji parametrik | Padanan nonparametrik | Kapan dipakai |
|---|---|---|
| Uji t sampel bebas | Mann-Whitney U | Membandingkan dua kelompok yang berbeda |
| Uji t sampel berpasangan | Wilcoxon signed-rank | Pretest dan posttest pada orang yang sama |
| ANOVA satu arah | Kruskal-Wallis H | Tiga kelompok atau lebih |
| ANOVA pengukuran berulang | Friedman | Tiga pengukuran atau lebih pada subjek yang sama |
| Korelasi Pearson | Spearman rho atau Kendall tau | Hubungan dua variabel |
| Regresi linear | Regresi robust, regresi kuantil, atau bootstrap | Model dengan prediktor lebih dari satu |
Perhatikan baris terakhir. Tidak ada padanan nonparametrik langsung untuk regresi berganda, dan inilah sebabnya mahasiswa manajemen serta akuntansi paling sering terjebak. Untuk model regresi, jalan keluarnya bukan mengganti uji melainkan memperbaiki model, memakai galat baku yang tahan terhadap penyimpangan, atau menggunakan bootstrap. Uji nonparametrik juga mengubah kalimat hipotesis Anda: Mann-Whitney membandingkan distribusi dan median, bukan rata-rata, jadi rumusan hipotesis di bab tiga harus ikut disesuaikan.

Pilihan 4: apa itu bootstrap dan mengapa jarang diajarkan?
Bootstrap mengambil ulang sampel Anda ribuan kali dengan pengembalian, menghitung statistik yang diminta pada setiap pengambilan, lalu menyusun selang kepercayaan dari sebaran hasil itu. Karena selang kepercayaan dibangun dari data Anda sendiri, asumsi normalitas tidak lagi diperlukan. Di SPSS, tombol Bootstrap tersedia pada banyak dialog analisis, termasuk regresi dan uji beda, dengan 1.000 atau 5.000 pengambilan ulang sebagai pilihan lazim.
Bootstrap jarang muncul di skripsi Indonesia bukan karena dilarang, melainkan karena tidak ada di buku panduan yang beredar di fakultas. Bila pembimbing Anda terbuka, ini adalah pilihan paling elegan: model tetap regresi, tafsir koefisien tetap dalam satuan asli, dan asumsi normalitas tidak lagi menjadi penghalang. Sebutkan jumlah pengambilan ulang dan jenis selang yang Anda pakai, lalu lampirkan keluarannya.
Bagaimana menuliskannya di bab tiga dan bab empat?
Penguji jarang mempermasalahkan angka Sig. itu sendiri. Yang dipermasalahkan adalah keputusan tanpa jejak. Tulis urutan ini di bab tiga sebagai rencana, lalu laporkan hasilnya di bab empat.
- Sebutkan uji normalitas yang dipakai dan pada objek apa: variabel, residual, atau data per kelompok.
- Laporkan nilai statistik uji, derajat bebas, dan Sig. secara lengkap, bukan hanya kata “tidak normal”.
- Sebutkan bukti pendukung: bentuk histogram, plot Q-Q, skewness dan kurtosis.
- Nyatakan keputusan dan alasannya dalam satu kalimat yang berdiri sendiri.
- Bila Anda beralih uji atau melakukan transformasi, sebutkan konsekuensinya terhadap tafsir hasil.
Contoh kalimat siap adaptasi: “Uji Shapiro-Wilk terhadap residual model regresi menghasilkan nilai 0,942 dengan Sig. 0,004, sehingga asumsi normalitas tidak terpenuhi. Mengingat pemeriksaan plot Q-Q menunjukkan penyimpangan hanya pada kedua ekor dan ukuran sampel 214 responden, analisis dilanjutkan dengan regresi berganda disertai selang kepercayaan bootstrap 5.000 pengambilan ulang.” Kalimat seperti ini menutup pertanyaan sebelum diajukan. Menyusun paragraf metodologi yang konsisten dari awal sampai akhir jauh lebih cepat bila kerangkanya sudah rapi sejak pemilihan metode penelitian.
Kesalahan yang membuat penguji langsung bertanya
- Menghapus responden sampai Sig. lewat 0,05. Ini bukan pembersihan data, dan jejaknya terlihat dari jumlah N yang berubah antara satu tabel dan tabel berikutnya.
- Menulis “data normal” padahal Sig. 0,000. Terjadi karena arah logika uji normalitas terbalik di kepala penulis. Periksa ulang setiap kalimat kesimpulan asumsi.
- Menyalin nilai dari keluaran orang lain. Angka statistik uji dan derajat bebas harus konsisten dengan jumlah responden yang Anda laporkan di bab tiga.
- Memakai uji nonparametrik tetapi tetap menulis hipotesis tentang rata-rata. Ganti kalimat hipotesisnya, bukan hanya nama ujinya.
- Melampirkan tangkapan layar yang tidak sesuai dengan tabel di naskah. Lampiran adalah tempat pertama yang dibuka penguji yang curiga.
Apa langkah paling masuk akal malam ini?
Buka data Anda dan kerjakan tiga hal berurutan: urutkan setiap variabel untuk memeriksa nilai ekstrem, jalankan uji normalitas pada objek yang benar (residual untuk regresi, per kelompok untuk uji beda), lalu putuskan satu jalur dari empat pilihan di atas dan tulis alasannya dalam satu paragraf. Setelah paragraf itu ada, bab tiga dan bab empat Anda punya tulang punggung yang tidak bisa digoyang.
Bagian yang paling melelahkan biasanya bukan analisisnya, melainkan menyusun ulang kalimat metodologi supaya konsisten di seluruh naskah. Tesify membantu Anda menyusun bab demi bab dengan struktur yang menjaga konsistensi antara rencana di bab tiga dan laporan di bab empat, sementara keputusan statistiknya tetap sepenuhnya milik Anda. Untuk urutan pemeriksaan asumsi selengkapnya, lihat panduan cara uji asumsi klasik di SPSS; untuk memilih perangkat lunaknya, bandingkan SPSS, JASP, dan Excel.
FAQ data tidak normal
Apakah data tidak normal berarti penelitian saya gagal?
Tidak. Ketidaknormalan adalah sifat data, bukan kesalahan peneliti. Yang menentukan mutu skripsi adalah apakah Anda mengenali sifat itu dan memilih analisis yang sesuai, lalu menjelaskan pilihannya.
Berapa nilai Sig. yang menandakan data normal?
Nilai Sig. lebih besar dari 0,05 berarti hipotesis nol tidak ditolak, sehingga data dianggap tidak berbeda nyata dari sebaran normal. Perhatikan bahwa “tidak ditolak” tidak sama dengan “terbukti normal”.
Shapiro-Wilk atau Kolmogorov-Smirnov yang harus saya pakai?
Shapiro-Wilk lazim dipilih untuk sampel kecil karena lebih peka; Kolmogorov-Smirnov dengan koreksi Lilliefors sering dilaporkan berdampingan. Pilih satu sebagai dasar keputusan, laporkan keduanya, dan sebutkan alasan pilihan Anda.
Apakah saya perlu menguji normalitas pada variabel dummy?
Tidak. Variabel biner tidak mungkin berdistribusi normal dan memang tidak diasumsikan demikian. Pada regresi, asumsi normalitas hanya menyangkut residual.
Bolehkah membuang pencilan agar data menjadi normal?
Boleh hanya jika ada alasan substantif, misalnya kesalahan pencatatan atau responden yang jelas di luar kriteria inklusi. Membuang pencilan semata demi lolos uji mengubah populasi penelitian dan harus dilaporkan lengkap dengan jumlah kasus yang dikeluarkan.
Apakah uji nonparametrik dianggap lebih rendah mutunya?
Tidak. Uji nonparametrik adalah pilihan metodologis yang sah dan pada sebaran menyimpang justru lebih tepat. Yang menurunkan mutu adalah memakai uji parametrik pada data yang jelas melanggar asumsinya.
Data saya ordinal dari skala Likert. Apakah perlu uji normalitas?
Bila setiap butir dianalisis sendiri sebagai data ordinal, uji nonparametrik lebih tepat sejak awal. Bila Anda menjumlahkan beberapa butir menjadi skor komposit dan memperlakukannya sebagai interval, praktik yang lazim di banyak bidang, maka uji normalitas dilakukan pada skor komposit itu.
Apakah transformasi data termasuk manipulasi data?
Tidak, selama dinyatakan terbuka. Transformasi adalah perubahan skala yang dapat diulang siapa pun dari data mentah yang sama. Yang termasuk manipulasi adalah mengubah nilai responden atau menghapus kasus tanpa dilaporkan.
Bagaimana bila pembimbing meminta hasilnya normal?
Bawa bukti pemeriksaan Anda: keluaran uji, histogram, plot Q-Q, dan tabel padanan uji di atas. Diskusi menjadi jauh lebih mudah ketika Anda datang dengan usulan analisis pengganti, bukan hanya dengan laporan bahwa data gagal uji.
Apakah JASP dan Excel bisa melakukan uji ini?
JASP menyediakan uji normalitas dan seluruh padanan nonparametrik pada tabel di atas tanpa biaya. Excel dapat menghitung skewness dan kurtosis serta korelasi peringkat dengan rumus, tetapi tidak menyediakan Shapiro-Wilk secara bawaan.
Berapa lama proses ini seharusnya memakan waktu?
Bila datanya sudah bersih, memeriksa asumsi dan memutuskan jalur analisis adalah pekerjaan satu sampai dua jam. Yang memakan berhari-hari biasanya adalah menulis ulang bab tiga agar cocok dengan keputusan baru itu.