Rumus Slovin dan tabel Krejcie-Morgan yang biasa dipakai untuk skripsi survei tidak berlaku untuk pengujian usability aplikasi — angka yang benar justru jauh lebih kecil, dan ada rumus berbeda di baliknya. Halaman ini menjawab pertanyaan yang sering membuat mahasiswa Teknik Informatika dan Sistem Informasi bingung: berapa jumlah partisipan yang cukup untuk uji usability, dan berapa untuk survei kepuasan pengguna.
Kenapa aturan sampel survei tidak berlaku untuk uji usability
Rumus Slovin dan tabel Krejcie-Morgan dirancang untuk menaksir parameter populasi dari sampel — cocok untuk survei kepuasan pengguna, tetapi tidak cocok untuk uji usability, yang tujuannya menemukan masalah desain, bukan menaksir proporsi populasi. Dua tujuan ini butuh logika sampel yang berbeda, dan menyamakan keduanya adalah kesalahan yang sering ditemukan penguji pada skripsi Teknik Informatika dan Sistem Informasi. Penentuan sampel untuk survei kuantitatif secara umum, termasuk rumus Slovin dan tabel Krejcie-Morgan, sudah dibahas lengkap di cara menentukan jumlah sampel skripsi. Halaman ini fokus pada kasus yang berbeda: pengujian usability dan survei kepuasan pengguna aplikasi.
Aturan lima pengguna untuk uji usability
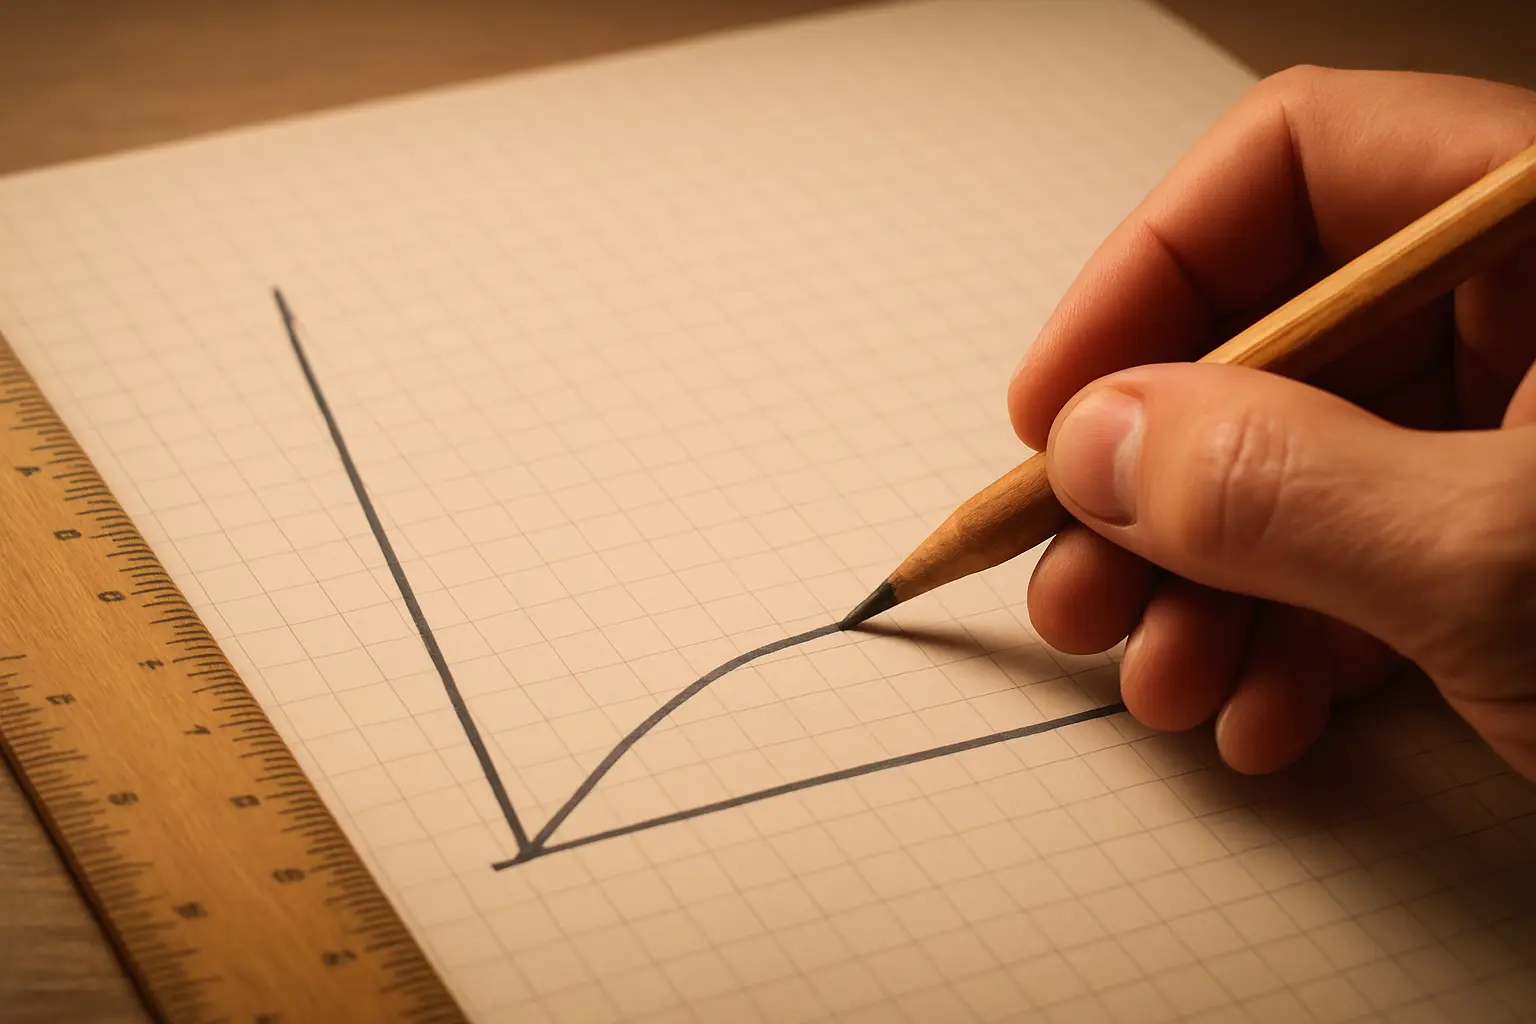
Jakob Nielsen, dalam artikelnya yang banyak dirujuk di bidang usability, menyatakan bahwa pengujian dengan lima pengguna menemukan sekitar 85% masalah usability dalam sebuah desain. Dasar matematisnya adalah rumus Nielsen dan Landauer: jumlah masalah yang ditemukan sama dengan N × (1 − (1 − L)n), dengan N = total masalah usability dalam desain, L = proporsi masalah yang ditemukan satu pengguna (biasanya sekitar 31%), dan n = jumlah pengguna yang diuji. Dengan L = 31% dan n = 5, hasilnya sekitar 84–85% dari N. Kurva ini naik tajam dari nol ke satu pengguna, lalu melandai setelah sekitar lima pengguna — menambah pengguna keenam dan seterusnya memberi tambahan temuan yang semakin kecil.
Rekomendasi Nielsen bukan “selalu pakai lima pengguna dan berhenti”, melainkan menguji secara iteratif: bila anggaran cukup untuk menguji 15 pengguna, ia menyarankan “belanjakan anggaran ini untuk 3 studi dengan masing-masing 5 pengguna”. Studi pertama menemukan sekitar 85% masalah dan dipakai memperbaiki desain; studi kedua menguji hasil perbaikan sekaligus menemukan masalah yang tersisa; studi ketiga menguji struktur yang lebih dalam seperti arsitektur informasi dan alur tugas. Untuk skripsi S1, satu putaran lima pengguna sudah lazim diterima sebagai uji usability formatif, tetapi menyebutkan potensi iterasi kedua di bagian saran menunjukkan pemahaman metodologis yang lebih matang.
Berapa responden untuk mengukur skor System Usability Scale (SUS)
Bila skripsi Anda memakai kuesioner System Usability Scale (SUS) untuk mengukur persepsi kegunaan aplikasi secara numerik — bukan sekadar mengamati pengguna menyelesaikan tugas — jumlah respondennya menentukan seberapa sempit rentang kepercayaan skor Anda. MeasuringU menghitung lebar interval kepercayaan (dengan standar deviasi SUS sekitar 17,7) untuk beberapa target margin kesalahan berikut.
| Margin kesalahan | n (tingkat kepercayaan 90%) | n (tingkat kepercayaan 95%) |
|---|---|---|
| ±15 poin | 6 | 8 |
| ±10 poin | 11 | 15 |
| ±7,5 poin | 17 | 24 |
| ±5 poin | 36 | 51 |
MeasuringU merekomendasikan margin kesalahan ±5 poin sebagai titik awal yang wajar, karena rentang sepuluh poin itu kira-kira sepadan dengan pembagian huruf mutu skor SUS (misalnya D untuk 52–63, C untuk 63–73, B untuk 73–79). Untuk skripsi S1 dengan keterbatasan waktu dan akses responden, margin ±10 sampai ±15 poin (n = 11–15 pada tingkat kepercayaan 90%) umumnya masih diterima selama Anda menyatakan margin itu secara eksplisit di Bab III dan tidak mengklaim presisi yang tidak didukung jumlah respondennya.
Dua metode, dua logika jumlah responden
| Metode | Tujuan | Logika jumlah responden | Angka acuan |
|---|---|---|---|
| Uji usability (task-based) | Menemukan masalah desain | Temuan melandai secara matematis, bukan representasi statistik populasi | 5 pengguna per iterasi (Nielsen) |
| Kuesioner SUS | Mengukur skor persepsi kegunaan | Presisi interval kepercayaan bertambah dengan akar jumlah responden | 11–51 tergantung margin yang diinginkan (MeasuringU) |
| Survei kepuasan pengguna umum | Menaksir proporsi/rata-rata di populasi pengguna | Rumus Slovin atau tabel Krejcie-Morgan berdasarkan ukuran populasi | Lihat panduan sampel skripsi umum |
Ketiga metode ini boleh dipakai bersama dalam satu skripsi sebagai triangulasi — misalnya uji usability task-based untuk menemukan masalah interaksi, kuesioner SUS untuk skor persepsi yang bisa dibandingkan sebelum dan sesudah revisi, dan survei kepuasan yang lebih luas bila skripsi juga ingin mengklaim generalisasi ke populasi pengguna yang lebih besar. Yang penting, setiap metode dilaporkan dengan justifikasi jumlah respondennya sendiri di Bab III — jangan menjumlahkan ketiganya menjadi satu angka “jumlah sampel penelitian” seolah mengukur hal yang sama.
Kriteria memilih partisipan, bukan cuma jumlahnya
Jumlah partisipan hanya separuh cerita — separuh lainnya adalah siapa mereka. Kurva 85% masalah Nielsen mengasumsikan partisipan mewakili populasi pengguna target; lima partisipan yang seluruhnya berasal dari latar belakang yang sama (misalnya semua mahasiswa informatika sendiri) akan menemukan masalah yang bias ke satu profil pengguna, bukan masalah yang dialami pengguna awam. Untuk skripsi pengembangan aplikasi dengan target pengguna umum — misalnya aplikasi presensi untuk guru, atau aplikasi kesehatan untuk lansia — kriteria pemilihan partisipan yang wajib dituliskan di Bab III meliputi: rentang usia yang representatif, tingkat literasi digital yang bervariasi (bukan seluruhnya mahir teknologi), dan familiaritas dengan aplikasi sejenis. Menguji lima teman sekelas yang seluruhnya mahasiswa TI adalah kesalahan sampel yang sama merusaknya dengan jumlah yang terlalu sedikit.
Menentukan jumlah iterasi, bukan hanya jumlah partisipan per sesi
Skripsi yang menggambarkan uji usability sebagai proses satu kali (single-shot) kehilangan bagian penting dari metodologi Nielsen: temuan dari studi pertama dipakai memperbaiki desain, lalu diuji ulang. Untuk skripsi S1 dengan waktu terbatas, dua iterasi realistis dilakukan: iterasi pertama dengan 5 partisipan menemukan masalah mayor, revisi prototipe berdasarkan temuan itu, lalu iterasi kedua dengan 3–5 partisipan baru (bukan partisipan yang sama, untuk menghindari bias familiaritas) memverifikasi apakah masalah mayor sudah teratasi. Menuliskan rencana dua iterasi ini di proposal, meski hanya satu yang sempat dilaksanakan penuh karena keterbatasan waktu, menunjukkan pemahaman metodologis yang lebih kuat daripada berhenti di satu putaran tanpa penjelasan.
Contoh penerapan untuk skripsi pengembangan aplikasi
Misalkan skripsi Anda mengembangkan aplikasi presensi berbasis QR code dan menguji usability-nya. Rancangan sampel yang wajar: 5–8 partisipan untuk uji usability task-based (mengamati mereka menyelesaikan tugas seperti scan QR dan melihat riwayat presensi, mencatat di mana mereka tersendat), ditambah kuesioner SUS ke 12–15 responden yang sama atau lebih luas untuk mendapat skor numerik dengan margin kesalahan yang bisa dilaporkan secara eksplisit di Bab III. Jumlah ini jauh lebih kecil dari sampel survei kepuasan berbasis populasi, dan itu wajar — keduanya menjawab pertanyaan penelitian yang berbeda.
Setelah uji usability dan SUS, langkah pengembangan aplikasi biasanya berlanjut ke evaluasi model (bila skripsi melibatkan machine learning) yang memakai metrik sama sekali berbeda dari usability — perbandingan confusion matrix, presisi, recall, dan metrik evaluasi model lainnya dibahas terpisah di confusion matrix vs metrik evaluasi model skripsi TI, karena keduanya adalah tahap evaluasi yang berbeda dengan jenis data yang berbeda pula.
Menulis ini di Bab III agar tidak dipertanyakan penguji
- Sebutkan metode secara eksplisit — usability task-based, kuesioner SUS, atau survei kepuasan — karena masing-masing punya logika sampel sendiri.
- Kutip dasar teoretisnya, bukan sekadar menuliskan angka. “5 partisipan (Nielsen, 2000)” jauh lebih kuat daripada “5 partisipan karena keterbatasan waktu”.
- Nyatakan margin kesalahan bila memakai SUS, bukan hanya melaporkan skor tunggal tanpa konteks presisi.
- Jangan mencampur logika Slovin dengan logika usability — menghitung sampel usability dengan rumus Slovin adalah kesalahan konseptual yang mengaburkan tujuan pengujian.
Delapan langkah menulis BAB III skripsi Teknik Informatika secara umum, termasuk memilih metode pengembangan dan merancang pengujian black-box, white-box, serta ISO/IEC 25010, dibahas lengkap di cara menulis BAB III skripsi Teknik Informatika.
Kalau skripsi Anda belum menentukan topik pengembangan aplikasi
Tiga puluh judul skripsi Teknik Informatika dan Sistem Informasi 2026 — mulai dari pembelajaran mesin, NLP bahasa Indonesia, visi komputer, sistem informasi dan aplikasi seluler, IoT, sampai keamanan siber — masing-masing lengkap dengan rumusan masalah, metode, dan sumber datanya, ada di 30 judul skripsi Teknik Informatika dan Sistem Informasi 2026. Setiap judul di sana yang melibatkan pengujian oleh pengguna akhir akan memakai logika jumlah responden yang sama seperti dibahas di halaman ini.
Kesalahan yang paling sering dipertanyakan penguji
| Kesalahan | Kenapa dipertanyakan |
|---|---|
| Memakai rumus Slovin untuk menentukan jumlah partisipan uji usability | Slovin menaksir populasi; usability menemukan masalah desain — logika berbeda |
| Melaporkan skor SUS tunggal tanpa menyebut jumlah responden atau margin kesalahan | Skor tanpa konteks presisi tidak bisa dinilai keandalannya |
| Menguji dengan 2–3 partisipan tanpa penjelasan | Di bawah titik plateau kurva Nielsen, temuan belum representatif untuk masalah mayor |
| Menyamakan “pengguna” uji usability dengan “responden” survei di pembahasan | Keduanya diperoleh dengan metode dan tujuan yang berbeda, tidak bisa digabung begitu saja |
Menyusun Bab III dan hasil uji usability tanpa bolak-balik referensi
Bagian yang paling sering membuat mahasiswa TI/SI terjebak bukan menjalankan uji usability-nya, melainkan menjelaskan dasar teoretis jumlah partisipannya secara meyakinkan di Bab III. Tesify membantu Anda menyusun bab metodologi dan hasil pengujian dalam satu tempat yang saling terhubung, sehingga argumen jumlah sampel Anda konsisten dari proposal sampai laporan akhir. Isi dan tanggung jawab penuh atas karya itu tetap milik Anda.
Mulai menyusun skripsi Teknik Informatika Anda di Tesify — 100% ditulis oleh Anda.
Pertanyaan yang sering diajukan
Apakah lima pengguna cukup untuk skripsi S1?
Untuk uji usability formatif (menemukan masalah desain), lima pengguna per iterasi adalah acuan yang diterima luas dan bersumber dari penelitian Nielsen dan Landauer. Sebutkan sumbernya di Bab III agar penguji melihat dasar teoretisnya, bukan sekadar angka tanpa rujukan.
Kenapa lima pengguna cukup untuk usability tapi tidak cukup untuk survei?
Karena tujuannya berbeda. Uji usability mencari masalah desain, dan kurva temuannya melandai cepat setelah lima pengguna. Survei menaksir proporsi atau rata-rata pada populasi, yang presisinya bergantung pada ukuran sampel relatif terhadap populasi — logika yang mendasari rumus Slovin dan tabel Krejcie-Morgan.
Berapa responden minimal untuk skor SUS yang bisa dipertanggungjawabkan?
Tidak ada angka tunggal yang mutlak — tergantung margin kesalahan yang Anda terima. Berdasarkan data MeasuringU, n = 15 pada tingkat kepercayaan 95% memberi margin sekitar ±10 poin, sementara n = 51 diperlukan untuk margin ±5 poin.
Apakah boleh menggabung uji usability dan survei kepuasan dalam satu skripsi?
Boleh, dan lazim dilakukan — asalkan keduanya dilaporkan terpisah dengan metode dan jumlah responden masing-masing yang dijustifikasi sendiri, bukan digabung menjadi satu angka sampel.
Apakah rumus Nielsen dan Landauer berlaku untuk semua jenis aplikasi?
Rumus ini berasal dari studi umum terhadap desain antarmuka dan diterima luas sebagai heuristik, tetapi bukan hukum matematis mutlak untuk setiap konteks. Aplikasi dengan pengguna yang sangat beragam (misalnya lintas usia atau lintas tingkat literasi digital) kadang membutuhkan lebih dari lima pengguna per segmen agar representatif.
Apa beda uji usability formatif dan sumatif?
Uji formatif dilakukan selama proses desain untuk menemukan dan memperbaiki masalah, cocok dengan pendekatan lima pengguna per iterasi. Uji sumatif mengukur performa akhir desain secara lebih presisi dan biasanya butuh responden lebih banyak, mendekati logika survei.
Bagaimana cara menuliskan jumlah partisipan usability di Bab III agar tidak dipertanyakan?
Sebutkan jenis pengujian (task-based atau kuesioner), jumlah partisipan, kriteria pemilihan partisipan, dan rujukan teoretis jumlah tersebut — misalnya heuristik Nielsen untuk uji task-based atau tabel margin kesalahan MeasuringU untuk SUS.
Apakah partisipan uji usability harus pengguna nyata aplikasi?
Idealnya ya, atau setidaknya mewakili karakteristik pengguna target (usia, tingkat literasi digital, konteks penggunaan). Menguji dengan teman sekelas yang bukan bagian dari populasi pengguna target adalah kelemahan metodologis yang sering dipertanyakan penguji.
Apakah jumlah partisipan usability perlu dihitung dengan power analysis?
Tidak untuk uji usability task-based — logika Nielsen bukan berbasis power analysis statistik. Power analysis lebih relevan untuk penelitian yang menguji hipotesis dengan uji statistik inferensial, seperti pada survei kepuasan atau eksperimen.
Bolehkah menggabungkan hasil tiga metode (usability, SUS, survei) menjadi satu angka jumlah sampel?
Sebaiknya tidak. Ketiganya mengukur hal berbeda dengan logika jumlah responden yang berbeda, sehingga digabung menjadi satu angka justru mengaburkan metodologi. Laporkan tiap metode dengan jumlah dan justifikasinya sendiri di Bab III.