| Metrik | Apa yang diukur | Kapan paling tepat dipakai | Kelemahan |
|---|---|---|---|
| Accuracy | Proporsi prediksi benar dari seluruh data | Kelas seimbang (jumlah data tiap kelas hampir sama) | Menyesatkan pada data tidak seimbang — model yang selalu menebak kelas mayoritas bisa terlihat “akurat” |
| Precision | Dari semua yang diprediksi positif, berapa persen benar-benar positif | False positive berbahaya/mahal (misalnya deteksi spam, sistem rekomendasi) | Tidak memperhitungkan berapa kasus positif yang terlewat (false negative) |
| Recall (Sensitivity) | Dari semua kasus positif sebenarnya, berapa persen berhasil terdeteksi | False negative berbahaya/mahal (misalnya deteksi penyakit, deteksi penipuan) | Tidak memperhitungkan berapa banyak alarm palsu (false positive) yang dihasilkan |
| F1-Score | Rata-rata harmonik precision dan recall | Kelas tidak seimbang dan kedua jenis kesalahan sama pentingnya | Sulit diinterpretasi langsung tanpa melihat precision dan recall aslinya |
| ROC-AUC | Kemampuan model membedakan kelas positif dan negatif di semua ambang klasifikasi | Membandingkan beberapa model secara keseluruhan, bukan pada satu ambang tertentu | Bisa terlihat baik meski performa pada kelas minoritas sebenarnya buruk |
Rekomendasi singkat: jangan melaporkan accuracy sendirian bila kelas data Anda tidak seimbang (misalnya 90 persen kelas A, 10 persen kelas B) — laporkan confusion matrix lengkap plus precision, recall, dan F1-score per kelas. Pakai ROC-AUC sebagai pembanding antar-model saat menulis BAB IV yang membandingkan beberapa algoritma. Confusion matrix bukan pesaing metrik-metrik ini — ia adalah tabel sumber yang menjadi dasar penghitungan semuanya.
Apa itu confusion matrix, dan mengapa jadi dasar semua metrik lain?
Confusion matrix adalah tabel yang membandingkan prediksi model dengan label sebenarnya, dipecah menjadi empat sel untuk klasifikasi biner: True Positive (TP, diprediksi positif dan memang positif), True Negative (TN, diprediksi negatif dan memang negatif), False Positive (FP, diprediksi positif padahal negatif — alarm palsu), dan False Negative (FN, diprediksi negatif padahal positif — kasus terlewat). Semua metrik pada tabel di atas — accuracy, precision, recall, F1-score — dihitung langsung dari empat angka ini. Melaporkan confusion matrix penuh di BAB IV, bukan hanya satu angka akurasi, memberi penguji gambaran utuh di mana model Anda salah dan seberapa sering.
Mengapa accuracy saja sering menyesatkan untuk skripsi Teknik Informatika?
Banyak dataset skripsi TI/SI tidak seimbang secara alami — misalnya deteksi transaksi penipuan (penipuan jauh lebih jarang dari transaksi normal), deteksi penyakit langka, atau klasifikasi ulasan negatif di antara mayoritas ulasan positif. Pada kondisi seperti ini, model yang selalu menebak kelas mayoritas bisa mencapai accuracy tinggi tanpa benar-benar mempelajari pola apa pun tentang kelas minoritas yang justru menjadi fokus penelitian. Penguji yang berpengalaman langsung curiga bila skripsi hanya melaporkan satu angka accuracy tanpa distribusi kelas dan confusion matrix — ini salah satu pertanyaan paling umum di sidang skripsi machine learning.
Kapan memilih precision, kapan memilih recall sebagai metrik utama?
Pilihan ini bergantung pada konsekuensi dunia nyata dari dua jenis kesalahan model Anda, bukan pada kebiasaan/selera.
- Utamakan precision saat false positive lebih mahal — misalnya sistem yang menandai transaksi sebagai mencurigakan lalu memblokirnya: menandai transaksi sah sebagai penipuan (false positive) mengganggu pengguna asli.
- Utamakan recall saat false negative lebih berbahaya — misalnya deteksi dini penyakit atau deteksi serangan siber: melewatkan kasus positif yang sebenarnya (false negative) bisa berakibat fatal, sementara alarm palsu sekadar merepotkan.
- Utamakan F1-score saat kedua jenis kesalahan sama pentingnya dan Anda perlu satu angka ringkas untuk membandingkan beberapa model atau setelan parameter.
Sebutkan alasan pemilihan metrik utama ini secara eksplisit di BAB III — bukan hanya di BAB IV setelah hasil keluar — karena penguji ingin tahu bahwa pemilihan metrik didasari pemahaman masalah, bukan dipilih karena kebetulan menghasilkan angka tertinggi.
Apa itu k-fold cross-validation, dan mengapa lebih disukai dibanding split data sekali saja?
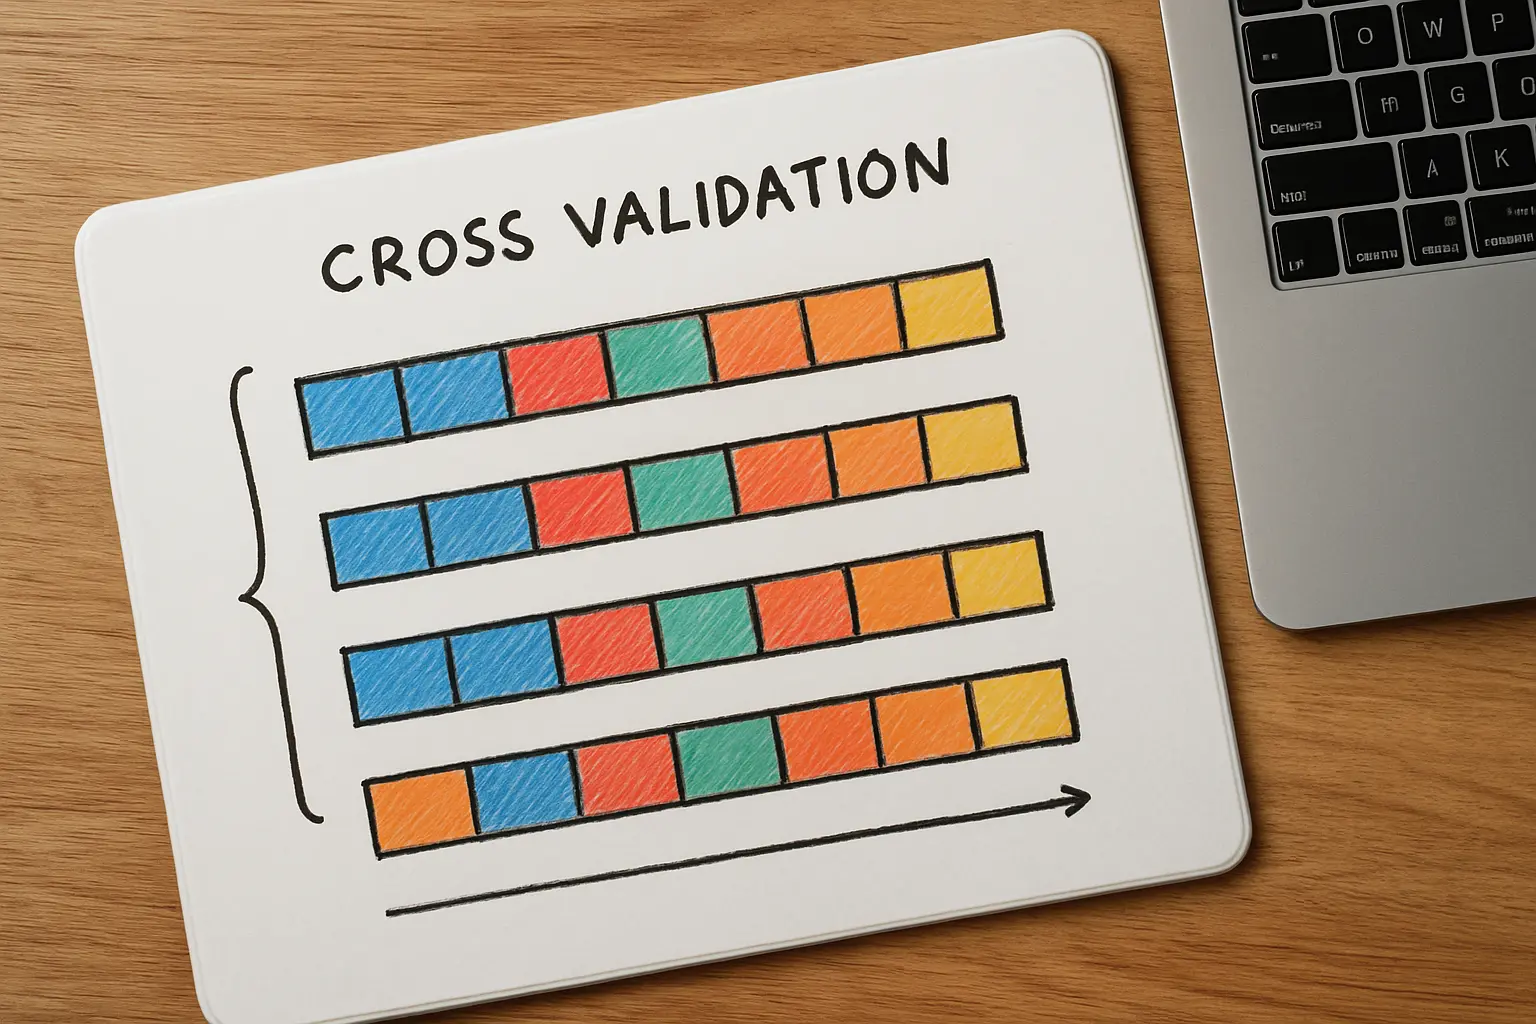
K-fold cross-validation membagi data menjadi k bagian (fold) sama besar, lalu melatih dan menguji model sebanyak k kali — setiap kali satu fold menjadi data uji dan sisanya data latih, bergiliran sampai semua fold pernah menjadi data uji. Hasil akhirnya adalah rata-rata metrik dari k percobaan, bukan hasil dari satu kali pembagian data (misalnya 80:20) yang bisa kebetulan menguntungkan atau merugikan model tergantung data mana yang jatuh ke sisi uji.
- k=5 atau k=10 adalah pilihan paling umum pada skripsi TI/SI — cukup untuk estimasi yang stabil tanpa waktu komputasi berlebihan pada dataset skala skripsi S1.
- Stratified k-fold menjaga proporsi kelas tetap sama di setiap fold, dan wajib dipakai bila dataset Anda tidak seimbang — k-fold biasa bisa menghasilkan fold yang kebetulan tidak memuat kelas minoritas sama sekali.
- Laporkan rata-rata dan standar deviasi dari k percobaan, bukan hanya rata-ratanya saja — standar deviasi menunjukkan seberapa stabil performa model di berbagai pembagian data.
Bagaimana menangani dataset yang tidak seimbang sebelum evaluasi model?
Ketidakseimbangan kelas sebaiknya ditangani sebelum tahap evaluasi, bukan hanya diperbaiki lewat pemilihan metrik. Beberapa pendekatan yang lazim dibahas di BAB III skripsi TI/SI:
- Oversampling kelas minoritas — menduplikasi atau membuat data sintetis untuk kelas yang jumlahnya sedikit (misalnya teknik SMOTE), diterapkan hanya pada data latih, bukan pada seluruh dataset sebelum split.
- Undersampling kelas mayoritas — mengurangi jumlah data kelas yang dominan agar proporsinya lebih seimbang dengan kelas minoritas, dengan risiko kehilangan informasi bila data yang dibuang ternyata penting.
- Pembobotan kelas (class weighting) — memberi bobot lebih besar pada kesalahan di kelas minoritas saat pelatihan model, tanpa mengubah jumlah data aslinya.
- Membiarkan data apa adanya dan mengandalkan pemilihan metrik yang tepat (precision, recall, F1 per kelas) — pilihan yang valid bila ketidakseimbangan mencerminkan kondisi nyata yang memang ingin dipelajari modelnya.
Sebutkan pendekatan yang dipilih beserta alasannya di BAB III, dan pastikan teknik penyeimbangan apa pun (oversampling/undersampling) hanya diterapkan pada data latih setelah split, bukan sebelum split — menerapkannya sebelum split adalah bentuk lain dari data leakage yang sering luput dari perhatian mahasiswa.
Bagaimana membandingkan beberapa algoritma secara adil di BAB IV?
- Pakai pembagian data dan preprocessing yang identik untuk semua algoritma yang dibandingkan — perbedaan hasil harus berasal dari algoritmanya, bukan dari perlakuan data yang berbeda.
- Laporkan semua metrik relevan per algoritma dalam satu tabel, bukan memilih metrik berbeda untuk tiap algoritma agar terlihat unggul di satu sisi.
- Sertakan waktu pelatihan/komputasi bila relevan dengan konteks penerapan (misalnya sistem yang harus real-time), karena algoritma dengan akurasi sedikit lebih rendah tapi jauh lebih cepat kadang lebih layak dipakai praktis.
- Uji signifikansi bila memungkinkan — pada skripsi S1 yang lebih maju, perbedaan performa antar-algoritma kadang diuji signifikansinya secara statistik, bukan hanya dibandingkan angka mentahnya, meski ini bukan syarat wajib di semua program studi.
Bila skripsi Anda juga membahas metodologi pengembangan sistem secara lebih luas (bukan hanya evaluasi model), pola penulisan BAB III yang mencakup metode pengembangan dan pengujian sistem dibahas pada cara menulis BAB III skripsi Teknik Informatika dan Sistem Informasi, yang melengkapi evaluasi model machine learning dengan konteks pengembangan sistem secara keseluruhan.
Bagaimana memvisualisasikan hasil evaluasi agar mudah dipahami pembimbing dan penguji?
Selain tabel angka, beberapa visualisasi membantu pembaca memahami performa model tanpa harus menghitung sendiri dari angka mentah: heatmap confusion matrix (warna lebih gelap untuk sel dengan jumlah lebih besar) memudahkan melihat pola kesalahan sekilas, kurva ROC untuk membandingkan beberapa model dalam satu grafik, dan grafik batang metrik per kelas untuk dataset multi-kelas. Sertakan visualisasi ini di BAB IV sebagai pelengkap tabel angka, bukan pengganti — penguji tetap perlu melihat angka pastinya, bukan hanya kesan visual dari grafik.
Apa kesalahan paling sering ditemukan penguji pada BAB IV evaluasi model?
- Hanya melaporkan accuracy tanpa confusion matrix atau metrik lain, terutama pada dataset tidak seimbang.
- Data uji “bocor” ke data latih (data leakage) — preprocessing seperti normalisasi dihitung dari seluruh dataset sebelum split, sehingga data uji sudah “mengintip” statistik data latih.
- Tidak menyebutkan pembagian data — rasio train-test atau skema k-fold yang dipakai tidak dijelaskan, membuat hasil tidak bisa direproduksi.
- Metrik dipilih berdasarkan hasil, bukan konteks masalah — melaporkan metrik yang kebetulan menghasilkan angka tertinggi tanpa justifikasi mengapa metrik itu relevan dengan tujuan sistem.
- Tidak menyebutkan hyperparameter yang dipakai tiap algoritma saat membandingkan beberapa model — perbandingan menjadi tidak adil bila satu algoritma di-tuning dan yang lain memakai setelan bawaan.
Bila Anda masih menentukan topik dan algoritma yang akan diteliti, contoh judul skripsi TI/SI lengkap dengan rumusan masalah dan metode ada pada 30 judul skripsi Teknik Informatika dan Sistem Informasi 2026 sebagai titik awal sebelum menentukan skema evaluasi model yang sesuai. Pola pertanyaan sidang seputar metodologi dan hasil secara umum, di luar yang spesifik teknis evaluasi model, dibahas pada bank pertanyaan penguji sidang skripsi per bab.
Menyusun BAB III dan BAB IV yang konsisten — dari pemilihan metrik hingga pelaporan hasil evaluasi — membantu menghindari revisi berulang menjelang sidang. Tesify membantu menyusun draf BAB III dan BAB IV skripsi Teknik Informatika agar deskripsi metrik, prosedur evaluasi, dan interpretasi hasil tetap sejalan dari bab satu sampai bab lima — mahasiswa tetap yang memilih metrik dan bertanggung jawab atas interpretasi hasil akhirnya.
Pertanyaan yang sering diajukan
Apakah wajib melaporkan semua metrik (accuracy, precision, recall, F1, ROC-AUC) sekaligus?
Tidak wajib melaporkan semuanya, tetapi minimal laporkan confusion matrix lengkap plus metrik yang paling relevan dengan konteks masalah Anda, dan jelaskan alasan pemilihannya.
Berapa nilai k yang ideal untuk k-fold cross-validation skripsi S1?
k=5 atau k=10 adalah pilihan paling umum dan cukup untuk kebanyakan skripsi TI/SI. Nilai k lebih besar memberi estimasi lebih stabil tetapi butuh waktu komputasi lebih lama.
Apakah boleh hanya memakai split data 80:20 tanpa k-fold?
Boleh, terutama bila dataset cukup besar dan waktu terbatas, tetapi sebutkan ini sebagai keterbatasan metodologis di BAB V, karena hasil dari satu kali split bisa dipengaruhi kebetulan pembagian data.
Apa itu data leakage dan bagaimana menghindarinya?
Data leakage terjadi ketika informasi dari data uji secara tidak sengaja “bocor” ke proses pelatihan, misalnya preprocessing dihitung dari seluruh dataset sebelum split. Hindari dengan selalu melakukan split data terlebih dahulu, baru menghitung statistik preprocessing (seperti normalisasi) hanya dari data latih.
Bagaimana melaporkan hasil bila model saya performanya rendah?
Laporkan apa adanya, jangan menyembunyikan atau memilih hanya metrik yang terlihat baik. Diskusikan kemungkinan penyebabnya (jumlah data terbatas, fitur kurang informatif, kelas tidak seimbang) sebagai bagian pembahasan yang substantif, bukan kegagalan yang harus ditutupi.
Apakah ROC-AUC bisa dipakai untuk klasifikasi lebih dari dua kelas?
Bisa, dengan pendekatan one-vs-rest yang menghitung ROC-AUC untuk tiap kelas dibanding gabungan kelas lainnya, lalu dirata-ratakan. Ini lebih kompleks dibanding kasus biner dan sebaiknya dijelaskan pendekatannya secara eksplisit di BAB III.
Apakah confusion matrix hanya berlaku untuk dua kelas?
Tidak, confusion matrix bisa diperluas untuk banyak kelas menjadi matriks persegi berukuran jumlah kelas dikali jumlah kelas, di mana diagonalnya menunjukkan prediksi benar dan sel di luar diagonal menunjukkan jenis kesalahan spesifik antar-pasangan kelas.
Apa beda macro-average dan weighted-average saat melaporkan metrik multi-kelas?
Macro-average menghitung metrik untuk tiap kelas lalu merata-ratakannya sama rata, tanpa memperhitungkan jumlah data per kelas — cocok bila semua kelas dianggap sama penting. Weighted-average memberi bobot sesuai proporsi jumlah data tiap kelas, sehingga kelas dengan data lebih banyak lebih memengaruhi angka akhir. Sebutkan pendekatan mana yang dipakai, karena keduanya bisa menghasilkan angka yang cukup berbeda pada dataset tidak seimbang.
Apakah boleh membandingkan hasil skripsi saya dengan angka dari penelitian lain sebagai tolok ukur?
Boleh sebagai pembanding di BAB IV, tetapi jelaskan bahwa perbandingan langsung punya keterbatasan bila dataset, jumlah data, dan skema evaluasi (rasio split, nilai k) antara penelitian Anda dan penelitian pembanding berbeda — angka yang lebih tinggi atau rendah tidak selalu berarti model Anda lebih baik atau lebih buruk secara adil.
Berapa lama waktu komputasi yang wajar untuk k-fold cross-validation pada skripsi S1?
Tergantung ukuran dataset dan kompleksitas algoritma, tetapi bila k-fold pada dataset skripsi S1 memakan waktu berjam-jam, pertimbangkan mengurangi nilai k, menyederhanakan grid pencarian hyperparameter, atau memakai subset data yang representatif untuk eksperimen awal sebelum menjalankan evaluasi penuh pada model final.