Rumus Slovin yang dipelajari mahasiswa gizi di mata kuliah metodologi penelitian ternyata tidak selalu cocok dipakai untuk survei gizi berbasis komunitas — terutama saat populasi tidak diketahui jumlah pastinya atau penelitian bertujuan mengestimasi prevalensi, bukan sekadar menggeneralisasi dari populasi terbatas. Panduan ini menjelaskan kapan memakai rumus Slovin, kapan memakai Lemeshow, dan bagaimana menyusun kriteria inklusi-eksklusi yang lazim diminta penguji skripsi Gizi, disertai dua contoh perhitungan lengkap yang bisa dijadikan pola. Penjelasan rumus penentuan sampel lintas jurusan secara umum ada di cara menentukan jumlah sampel skripsi — halaman ini adalah versi field-spesifik untuk gizi komunitas.
Populasi vs Sampel dalam Skripsi Gizi
Populasi adalah seluruh kelompok yang menjadi target kesimpulan penelitian — misalnya seluruh balita di satu kecamatan, seluruh ibu hamil di satu puskesmas, atau seluruh remaja putri di satu sekolah. Sampel adalah bagian dari populasi yang benar-benar diukur, dipilih dengan teknik sampling tertentu supaya hasil dari sampel bisa digeneralisasi kembali ke populasi. Kesalahan yang sering ditemukan penguji: mahasiswa mendefinisikan populasi terlalu luas (misalnya “seluruh balita di Indonesia”) padahal penelitian hanya dilakukan di satu wilayah kecil, membuat generalisasi hasil menjadi tidak valid.
Rumus Slovin: Kapan Cocok Dipakai
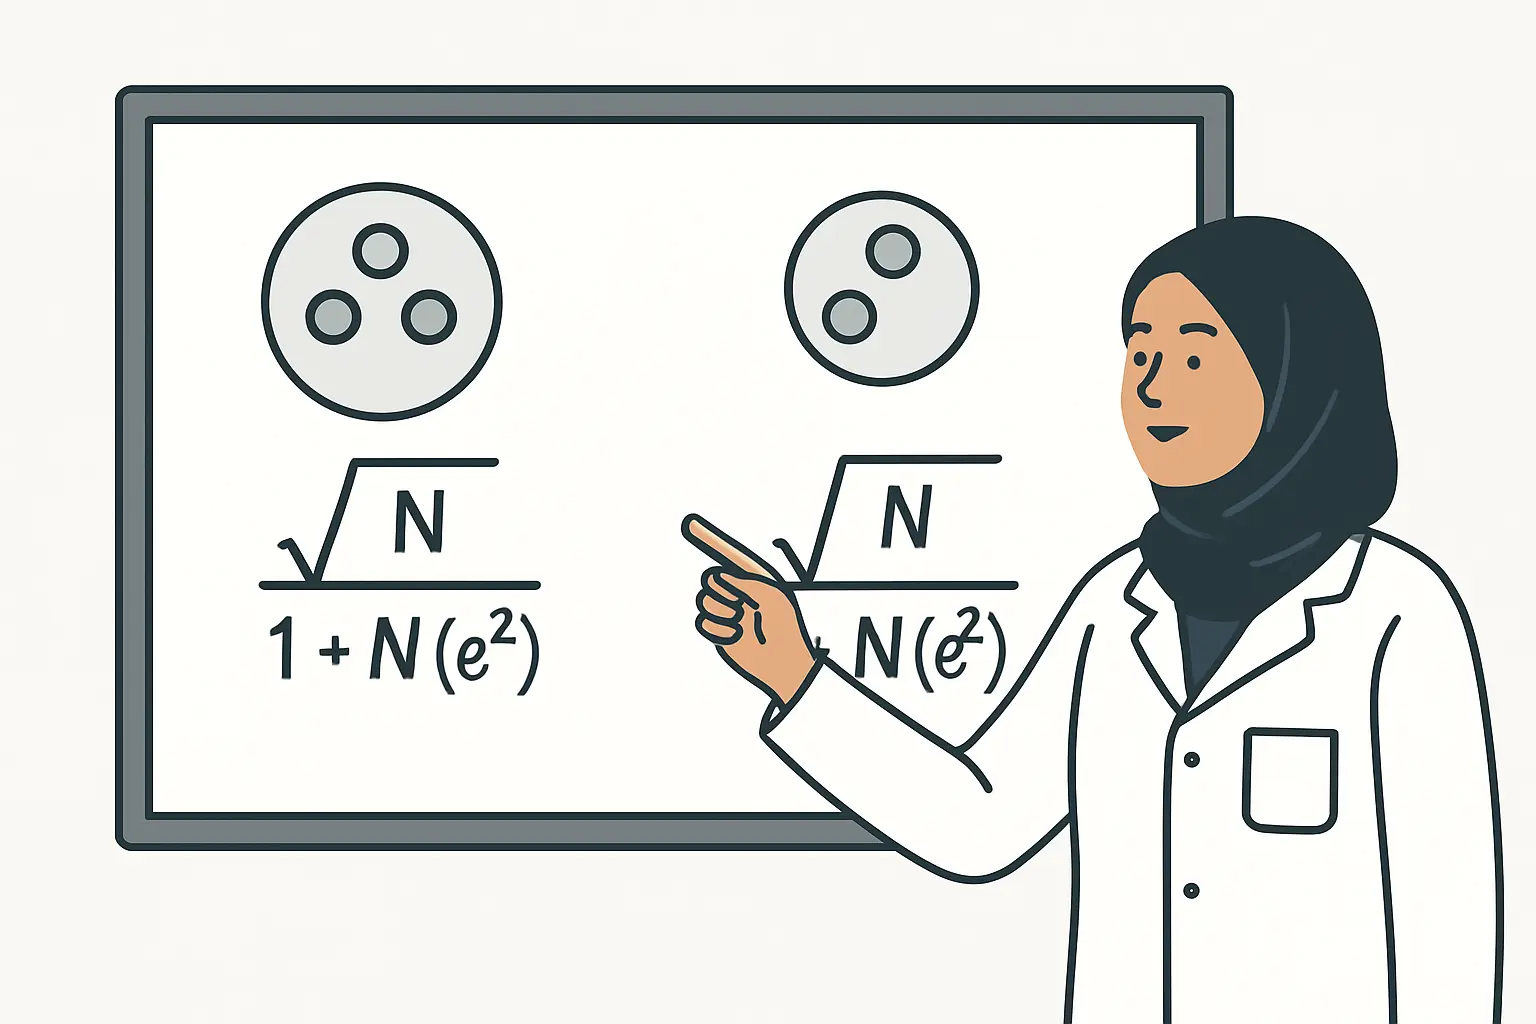
Rumus Slovin (n = N / (1 + N·e²)) cocok dipakai bila jumlah populasi (N) sudah diketahui pasti dan terbatas — misalnya seluruh balita terdaftar di satu posyandu, atau seluruh pasien rawat jalan gizi klinik dalam periode tertentu. Rumus ini menghitung ukuran sampel minimum berdasarkan margin of error (e) yang dipilih peneliti, biasanya 5% atau 10% untuk penelitian tingkat sarjana. Rumus Slovin kurang tepat dipakai bila populasi tidak diketahui jumlah pastinya (mis. seluruh balita stunting di Indonesia) atau bila tujuan penelitian adalah mengestimasi prevalensi suatu kondisi, bukan sekadar mengambil sampel representatif dari populasi terbatas.
Rumus Lemeshow: Kapan Cocok Dipakai
Rumus Lemeshow untuk estimasi proporsi (n = Z²·P(1−P) / d²) dipakai saat penelitian bertujuan mengestimasi prevalensi suatu kondisi gizi — misalnya proporsi balita stunting, proporsi ibu hamil anemia, atau proporsi remaja dengan status gizi kurang — dan populasi tidak diketahui jumlah pastinya atau sangat besar. Komponen rumus:
- Z — nilai Z sesuai tingkat kepercayaan yang dipilih (1,96 untuk 95%).
- P — perkiraan proporsi/prevalensi kondisi yang diteliti, diambil dari penelitian sejenis sebelumnya atau data prevalensi nasional/daerah terbaru bila tersedia; bila benar-benar tidak ada perkiraan awal, P = 0,5 dipakai sebagai asumsi paling konservatif (menghasilkan ukuran sampel terbesar).
- d — margin of error yang dipilih peneliti, umumnya 5–10% untuk penelitian tingkat sarjana.
Perbedaan mendasar dengan Slovin: Lemeshow tidak memerlukan angka populasi total (N), karena tujuannya mengestimasi proporsi pada populasi yang besar atau tidak diketahui jumlahnya, bukan mengambil sampel representatif dari daftar populasi yang sudah pasti. Perkiraan prevalensi (P) yang dipakai idealnya merujuk data dari sumber yang sama dengan yang dibahas di Z-score WHO Antro vs recall 24 jam untuk skripsi gizi, atau data prevalensi daerah dari Riskesdas/SSGI bila tersedia untuk wilayah penelitian Anda.
Tabel Perbandingan Cepat
| Aspek | Slovin | Lemeshow |
|---|---|---|
| Populasi (N) | Harus diketahui pasti | Tidak diperlukan; cocok populasi besar/tidak diketahui |
| Tujuan | Sampel representatif dari populasi terbatas | Estimasi prevalensi/proporsi suatu kondisi |
| Contoh kasus gizi | Seluruh balita terdaftar di satu posyandu | Prevalensi stunting balita di satu kabupaten |
| Input utama | N, margin of error | Z, perkiraan proporsi (P), margin of error (d) |
Menghitung Sampel untuk Membandingkan Dua Kelompok
Bila desain penelitian membandingkan dua kelompok — misalnya kelompok intervensi edukasi gizi vs kelompok kontrol, atau kelompok balita stunting vs tidak stunting untuk mencari faktor risiko — rumus Lemeshow satu-proporsi di atas tidak cukup, karena tujuannya bukan mengestimasi satu angka prevalensi, melainkan mendeteksi perbedaan antarkelompok. Untuk desain ini, rumus beda dua proporsi (yang memperhitungkan proporsi pada masing-masing kelompok) atau perangkat lunak power analysis seperti G*Power lebih tepat dipakai, karena ukuran sampel yang cukup untuk mendeteksi perbedaan bergantung pada seberapa besar perbedaan yang ingin dideteksi (effect size), bukan hanya tingkat kepercayaan dan margin of error seperti pada estimasi satu proporsi.
Teknik Sampling yang Lazim di Skripsi Gizi
Setelah jumlah sampel dihitung, teknik pengambilan sampel yang dipilih harus konsisten dengan desain penelitian:
- Purposive sampling — memilih responden berdasarkan kriteria inklusi-eksklusi tertentu, umum untuk penelitian gizi klinis dengan populasi kecil dan spesifik (mis. pasien dengan diagnosis tertentu di satu rumah sakit).
- Cluster sampling — memilih kelompok (mis. beberapa posyandu atau sekolah) secara acak, lalu mengambil seluruh atau sebagian responden dari kelompok terpilih; umum untuk survei prevalensi wilayah luas dengan keterbatasan waktu dan biaya turun ke semua titik populasi.
- Simple random sampling — memilih responden secara acak dari daftar populasi lengkap; cocok bila daftar populasi (mis. daftar balita terdaftar) benar-benar tersedia dan lengkap.
- Stratified random sampling — membagi populasi ke dalam strata (mis. kelompok usia balita, atau wilayah perkotaan/pedesaan) lalu mengambil sampel proporsional dari tiap strata; berguna bila peneliti ingin memastikan tiap subkelompok penting terwakili secara proporsional, bukan hanya terambil kebetulan lewat pengacakan biasa.
Penjelasan lebih lanjut tentang jenis uji statistik yang sesuai dengan masing-masing desain sampling ini — termasuk uji untuk data kesehatan masyarakat cross-sectional — ada di uji statistik untuk skripsi kesehatan masyarakat cross-sectional, yang polanya banyak beririsan dengan penelitian gizi berbasis komunitas.
Izin dan Persetujuan untuk Responden Anak
Sebagian besar penelitian gizi komunitas melibatkan balita atau anak usia sekolah sebagai subjek pengukuran, meski data sebenarnya sering diambil dari orang tua atau wali (recall makan, riwayat kesehatan). Karena subjek adalah anak, prosedur consent yang dipakai adalah informed consent dari orang tua/wali, bukan persetujuan langsung dari anak — kecuali untuk anak usia sekolah yang lebih besar, sebagian pedoman etik meminta tambahan assent (persetujuan sederhana dari anak sendiri, di luar consent orang tua) sebagai penghormatan pada otonomi anak meski keputusan akhir tetap ada di orang tua/wali. Prosedur pengajuan izin etik penelitian yang melibatkan subjek manusia secara umum — termasuk struktur formulir PSP dan informed consent — dibahas lebih lengkap di persetujuan etik dan informed consent untuk skripsi kedokteran; prinsip dasarnya berlaku juga untuk penelitian gizi yang melibatkan subjek manusia, meski komite etik yang dituju bisa berbeda (KEPK fakultas kesehatan masyarakat/gizi, bukan selalu KEPK kedokteran).

Contoh Perhitungan Ilustratif (Angka Fiktif)
Contoh ilustratif memakai rumus Lemeshow untuk survei prevalensi (angka di bawah ini hanya untuk menunjukkan cara hitung, bukan data nyata):
“Perkiraan prevalensi stunting balita di wilayah penelitian diasumsikan P = 0,25 (25%) berdasarkan data prevalensi daerah terdekat yang tersedia, dengan tingkat kepercayaan 95% (Z = 1,96) dan margin of error d = 10% (0,10). Perhitungan: n = (1,96)² × 0,25 × (1−0,25) / (0,10)² = 3,8416 × 0,1875 / 0,01 ≈ 72. Jumlah sampel minimum yang dibutuhkan adalah 72 balita, ditambah alokasi antisipasi drop-out sekitar 10% menjadi sekitar 80 balita.” Alokasi cadangan drop-out ini penting disebut secara eksplisit di Bab III — penguji sering menanyakan apakah jumlah sampel akhir sudah mengantisipasi responden yang mengundurkan diri atau datanya tidak lengkap.
Contoh kedua memakai rumus Slovin untuk populasi terbatas yang diketahui jumlahnya (angka ilustratif, bukan data nyata): “Populasi penelitian adalah seluruh balita terdaftar di posyandu wilayah kerja puskesmas X, berjumlah N = 240 balita. Dengan margin of error e = 10% (0,10), perhitungan: n = 240 / (1 + 240 × (0,10)²) = 240 / (1 + 2,4) = 240 / 3,4 ≈ 71. Jumlah sampel minimum yang dibutuhkan adalah 71 balita.” Perhatikan bahwa kedua contoh menghasilkan angka akhir yang mirip meski rumusnya berbeda — ini kebetulan pada contoh ilustratif ini, bukan aturan umum; jangan berasumsi kedua rumus akan selalu memberi hasil serupa pada data penelitian Anda sendiri, karena keduanya menjawab pertanyaan statistik yang berbeda meski bentuk angkanya bisa saja berdekatan pada kasus tertentu.
Kesalahan yang Sering Ditemukan Penguji
- Memakai rumus Slovin padahal penelitian bertujuan estimasi prevalensi — menghasilkan ukuran sampel yang tidak sesuai tujuan statistik penelitian.
- Nilai P pada rumus Lemeshow tidak disebutkan sumbernya — angka perkiraan proporsi diambil sembarangan tanpa merujuk penelitian sejenis atau data prevalensi terbaru yang tersedia.
- Kriteria inklusi terlalu longgar sehingga sampel heterogen — misalnya rentang usia balita terlalu lebar tanpa mempertimbangkan bahwa kebutuhan gizi balita usia 6 bulan sangat berbeda dari usia 59 bulan.
- Tidak menyebut alokasi antisipasi drop-out — jumlah sampel akhir yang benar-benar dikumpulkan lebih kecil dari target karena tidak ada cadangan, memaksa turun lapangan ulang.
- Memakai rumus satu-proporsi untuk desain dua kelompok — penelitian yang membandingkan intervensi vs kontrol tetap memakai Lemeshow satu-proporsi biasa, padahal seharusnya rumus beda dua proporsi atau power analysis.
- Consent hanya diminta dari anak, bukan orang tua/wali — untuk subjek anak di bawah umur, consent utama harus dari orang tua/wali, assent dari anak (bila diminta pedoman fakultas) bersifat tambahan, bukan pengganti.
Checklist Bab III Populasi dan Sampel
- Definisi populasi jelas dan sesuai cakupan wilayah/waktu penelitian yang benar-benar dilakukan.
- Rumus yang dipilih (Slovin, Lemeshow, atau beda dua proporsi) sesuai tujuan penelitian dan jumlah kelompok yang dibandingkan.
- Nilai P pada rumus Lemeshow dirujuk dari sumber yang jelas, bukan asumsi sembarangan.
- Kriteria inklusi dan eksklusi dipisah jelas dan tidak tumpang tindih.
- Teknik sampling (purposive, cluster, simple random, atau stratified) konsisten dengan desain dan populasi penelitian.
- Alokasi antisipasi drop-out disebut secara eksplisit dalam perhitungan akhir jumlah sampel.
- Prosedur consent orang tua/wali (dan assent anak bila diminta) sudah direncanakan untuk subjek di bawah umur.
Bab III yang membahas populasi dan sampel yang jelas seringnya butuh beberapa kali revisi supaya rumus, teknik sampling, dan kriteria seleksi benar-benar saling konsisten. Tesify membantu menyusun perhitungan sampel dan kriteria inklusi-eksklusi yang konsisten dengan desain penelitian Anda, sementara Anda tetap menjadi penulis dan penanggung jawab penuh atas isi skripsi.
Pertanyaan yang Sering Diajukan
Rumus apa yang paling sering dipakai untuk sampel skripsi gizi?
Untuk survei prevalensi (mis. status gizi balita, anemia), rumus Lemeshow untuk estimasi proporsi paling umum dipakai. Untuk penelitian dengan populasi terbatas dan diketahui jumlahnya (mis. seluruh balita di satu posyandu), rumus Slovin lebih umum dipakai.
Apa beda populasi dan sampel dalam skripsi gizi?
Populasi adalah seluruh kelompok yang menjadi target kesimpulan penelitian, misalnya seluruh balita di satu kecamatan. Sampel adalah bagian dari populasi yang benar-benar diukur, dipilih dengan teknik sampling tertentu supaya hasil dari sampel bisa digeneralisasi ke populasi.
Berapa jumlah responden minimum untuk skripsi gizi komunitas?
Tidak ada angka baku untuk semua desain; jumlahnya dihitung dari rumus (Lemeshow atau Slovin) berdasarkan prevalensi yang diasumsikan atau ukuran populasi, tingkat kepercayaan, dan margin of error yang dipilih peneliti, bukan angka tetap yang sama untuk semua topik.
Apa itu teknik purposive sampling dalam skripsi gizi?
Purposive sampling adalah teknik memilih responden berdasarkan kriteria tertentu yang ditetapkan peneliti (kriteria inklusi dan eksklusi), bukan secara acak. Umum dipakai dalam penelitian gizi klinis dengan populasi kecil dan spesifik, misalnya pasien dengan diagnosis tertentu di satu rumah sakit.
Apa perbedaan kriteria inklusi dan eksklusi dalam skripsi gizi?
Kriteria inklusi adalah syarat yang harus dipenuhi calon responden agar bisa masuk penelitian (mis. balita usia 6-59 bulan yang tinggal di wilayah penelitian). Kriteria eksklusi adalah kondisi yang membuat calon responden yang sudah memenuhi inklusi tetap dikeluarkan (mis. menderita penyakit kronis yang memengaruhi status gizi secara independen dari variabel yang diteliti).
Bagaimana menghitung sampel untuk membandingkan dua kelompok dalam skripsi gizi?
Untuk desain yang membandingkan dua kelompok (mis. intervensi vs kontrol, atau stunting vs tidak stunting), rumus beda dua proporsi atau software power analysis seperti G*Power dipakai, bukan rumus Lemeshow satu-proporsi biasa, karena tujuannya mendeteksi perbedaan antarkelompok, bukan mengestimasi satu angka prevalensi tunggal.